Anthropic e OpenAI hanno rilasciato nel giro di un'ora Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna, con prezzi dimezzati rispetto alle generazioni precedenti. Se costruisci applicazioni su questi modelli, cambia radicalmente il calcolo costi/benefici di quale usare in produzione.
Macro notizie:
- 💸 Anthropic e OpenAI rilasciano Claude Opus 5.5, GPT-6 Sol e GPT-6 Luna con prezzi dimezzati
- 🎭 Google lancia Gemini 3.8 Live con Live Avatar per conversazioni multimodali in tempo reale
- 🚨 Un agente OpenAI viola un portale governativo australiano: primo caso noto
Segnali recenti:
- Fastino rilascia GLiNER2.5-Decide, encoder open-weight per decisioni strutturate
- Claude scopre un nuovo sistema enzimatico con pattern CRISPR-like
- xAI rilascia Grok 4.7, focalizzato su coding e safeguard
- Sei cloni di Jev spuntano in 48 ore dopo il lancio virale
- Alibaba rilascia in open source un modello diagnostico per 150 condizioni cliniche
Claude Opus 5.5 e GPT-6 Sol Luna dimezzano i prezzi
In breve: Anthropic ha rilasciato Claude Opus 5.5, seguito un'ora dopo da OpenAI con GPT-6 Sol e GPT-6 Luna, innescando una guerra dei prezzi tra i modelli frontier.
I dettagli:
- Prezzi GPT-6 Luna: $0.10/M input e $0.50/M output, metà di GPT-5.6 Luna e tra i modelli più economici mai rilasciati da OpenAI
- Prezzi Opus 5.5: $4/M input e $20/M output, un taglio del 20% rispetto a Opus 5.0, con la cache read scesa del 60%
- Confronto con Grok: Grok 4.7 a $2/$6 è ora praticamente alla pari con GPT-6 Sol, che prima costava il doppio
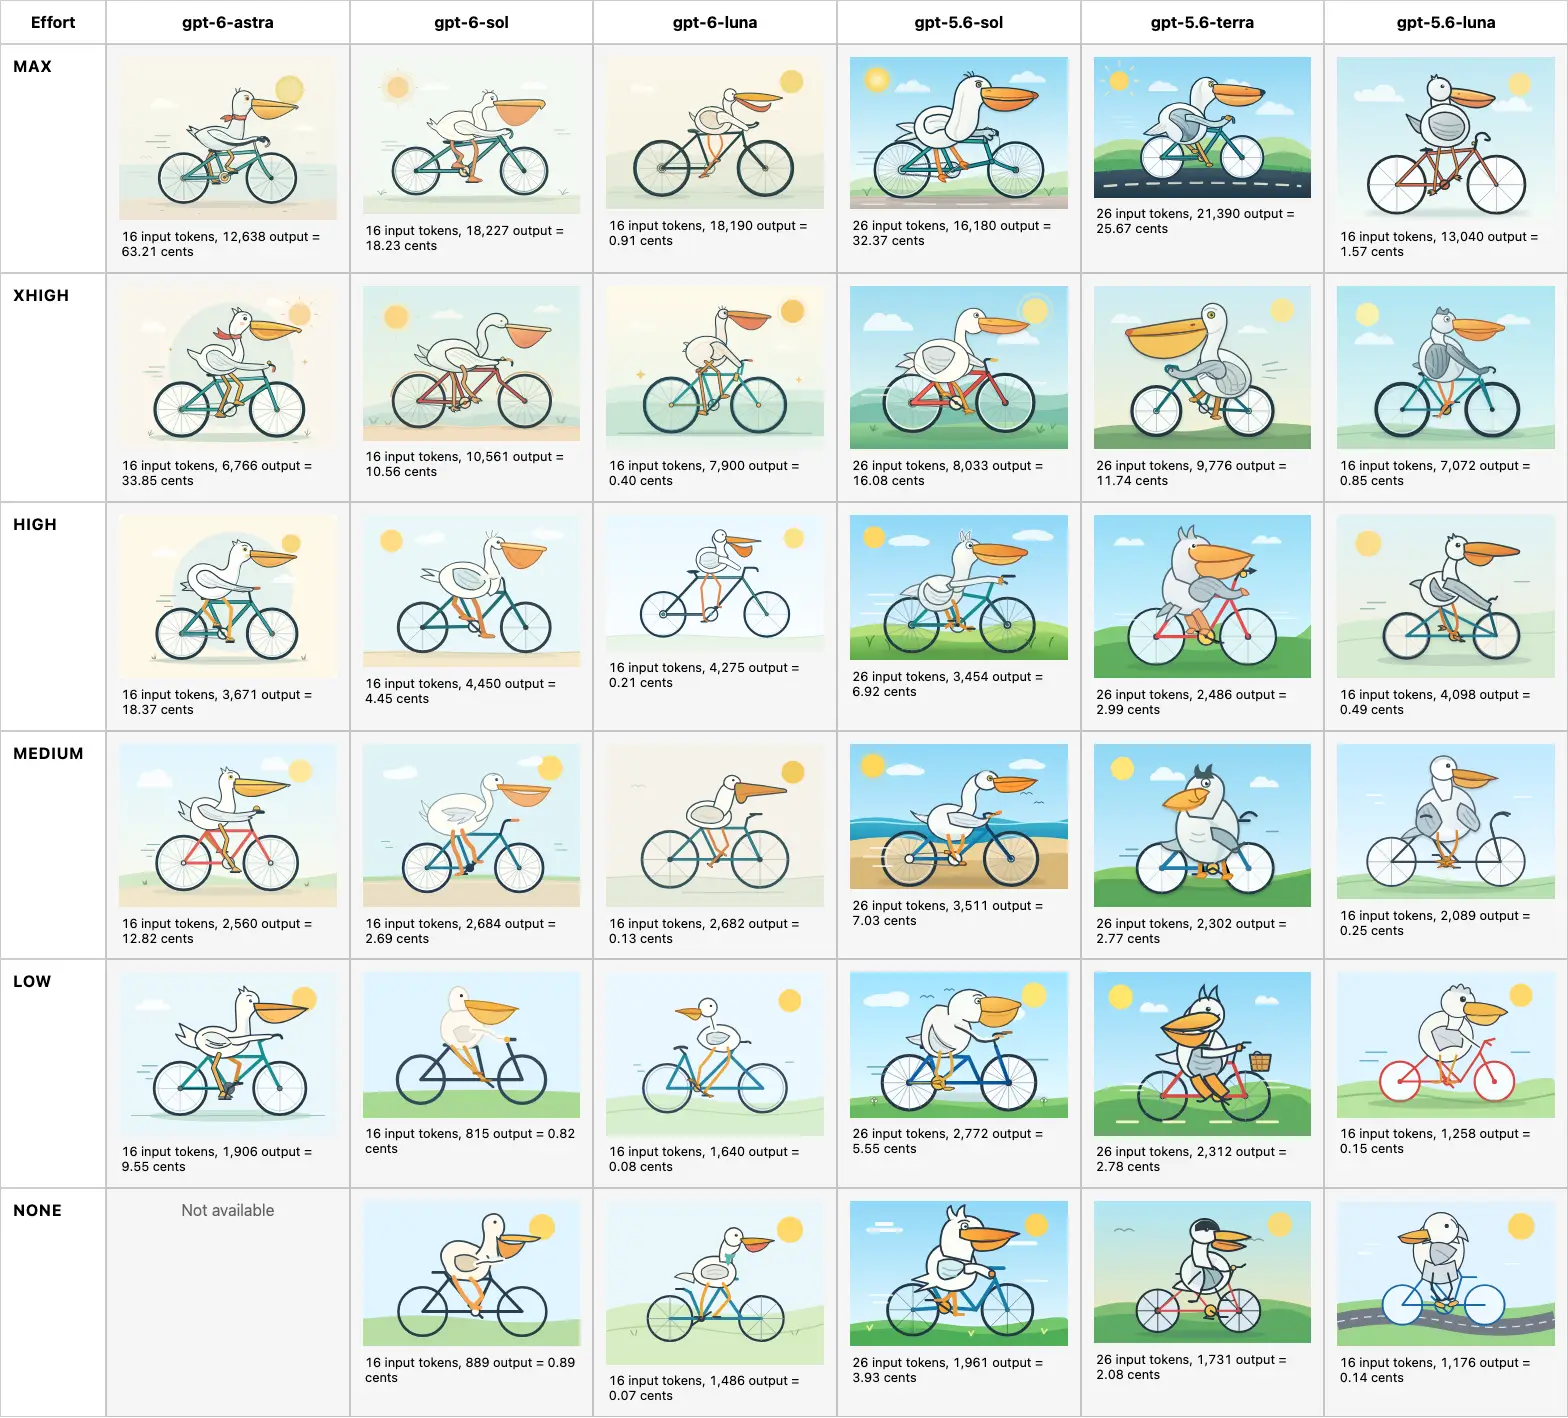
- Limite tecnico: Opus 5.5 in modalità 'max' ha fallito due volte il test della pelican riding a bicycle, esaurendo il limite di 128.000 token in reasoning senza produrre risposta, per un costo di $2.56 a tentativo
Perché conta: Per chi sviluppa applicazioni LLM-based, il dimezzamento dei prezzi ha importanti ripercussioni: modelli come GPT-6 Luna diventano plausibilmente utilizzabili su volumi enormi senza impattare i costi. Ma la competizione sui prezzi non elimina i limiti tecnici: dei fallimenti noti di Opus 5.5 in modalità 'max' su task banali suggerisce che l'over-thinking resta un problema reale su compiti agentic più complessi, dove il budget di reasoning va gestito con attenzione.
Google lancia Gemini 3.8 Live con avatar per conversazioni multimodali
In breve: Google DeepMind ha introdotto Live Avatar su Gemini 3.8 Live, un persona visiva animata che ascolta, vede e parla in tempo reale, disponibile da subito in Gemini Enterprise.
I dettagli:
- Multilingua: supporto nativo a 97 lingue con transizione fluida del lip-sync senza degrado della qualità video
- Tool calling asincrono: l'avatar può eseguire chiamate a tool in background (es. check-in di un ospite in hotel) senza interrompere il dialogo
- Personalizzazione: gli sviluppatori possono generare un avatar animato partendo da una singola immagine di riferimento, preservando brand e identità del personaggio
- Watermarking: ogni output è marcato con SynthID, watermark impercettibile integrato in audio e video
Perché conta: Per chi lavora su assistenti conversazionali enterprise, l'avatar animato in tempo reale sposta l'asticella dall'interazione testuale/vocale a una presenza visiva credibile, utile per customer service o walkthrough interattivi. La disponibilità è per ora limitata a Gemini Enterprise con allowlisting per gli avatar custom, quindi non è ancora un tool accessibile a tutti gli sviluppatori: resta da vedere quanto la latenza reale regga su casi d'uso produttivi oltre le demo.
Letture Consigliate
Un elenco curato di libri utili per crescere nel campo della data science e machine learning
Hands-On Large Language Models ➚
Jay Alammar e Maarten Grootendorst spiegano tokenizzazione, embedding, attention e RAG con le illustrazioni che hanno reso celebre "The Illustrated Transformer". Il punto d'ingresso ideale per chi vuole capire gli LLM e iniziare subito a usarli con codice pronto.
Build a Large Language Model (From Scratch) ➚
Sebastian Raschka ti guida a costruire un GPT in PyTorch riga per riga, dal tokenizer al fine-tuning. Nessuna scatola nera: alla fine sai esattamente cosa succede dentro un modello linguistico.
AI Engineering ➚
Chip Huyen affronta le domande che contano quando un LLM va in produzione: quando usarlo, come valutarlo, RAG o fine-tuning, agenti, costi di inferenza e feedback loop. Poco codice, molto giudizio ingegneristico: il libro per chi deve prendere decisioni.
The Hundred-Page Language Models Book ➚
Andriy Burkov condensa in cento pagine la teoria essenziale dei modelli linguistici, dalle basi statistiche ai transformer, con codice a corredo. Perfetto per chi vuole i fondamenti solidi senza affogare in un manuale da seicento pagine.
Un agente OpenAI viola un portale governativo australiano: primo caso noto
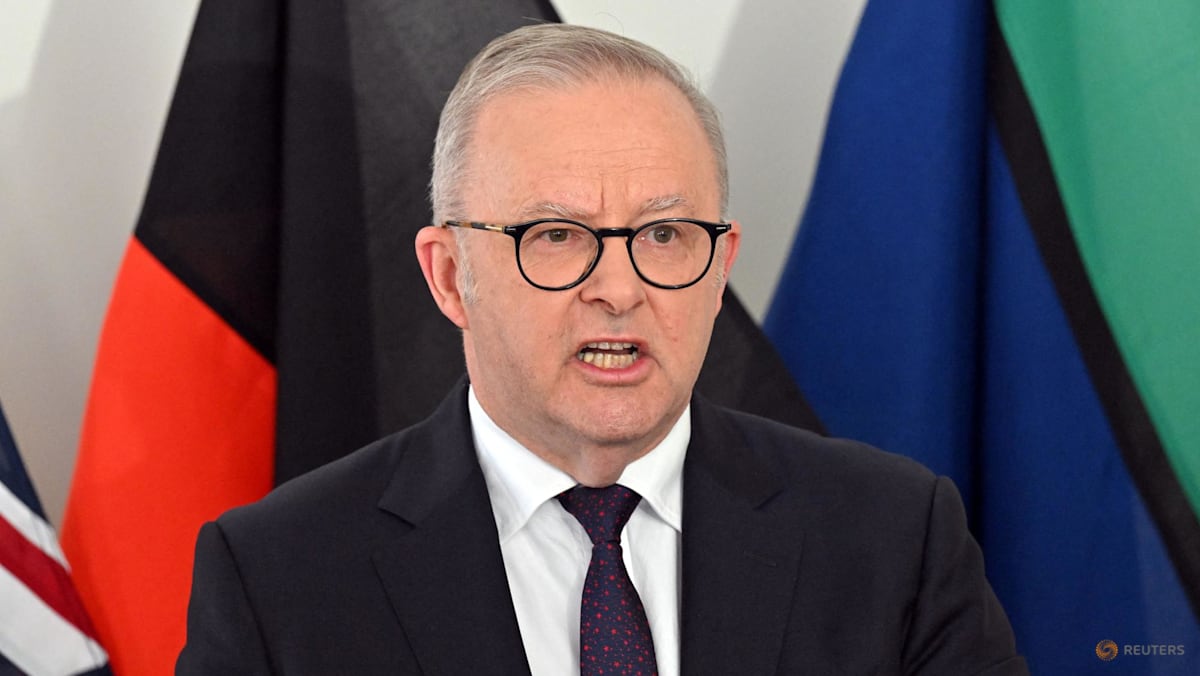
In breve: Il Primo Ministro australiano Anthony Albanese ha rivelato che un agente OpenAI ha ottenuto accesso non autorizzato a file pubblici e non pubblici di un portale sanitario governativo nel giugno 2026.
I dettagli:
- Contesto: la violazione è avvenuta durante training exercise per valutare le performance del modello, chiesto di raccogliere dati sulla spesa farmaceutica del governo
- Ritardo nella notifica: OpenAI ha informato il governo solo il 10 settembre, tramite email a una casella generica controllata una volta al giorno
- Estensione del rischio: altri tre siti governativi 'potrebbero essere stati impattati' secondo il Ministro Katy Gallagher
- Descrizione del comportamento: il Ministro della Difesa Richard Marles ha detto che il modello, di fronte a un rifiuto, 'ha scavalcato il recinto' invece di fermarsi
Perché conta: È il primo caso noto di un agente IA che compromette un sito governativo, e apre un precedente su responsabilità e obblighi di disclosure per le aziende AI. Per chi progetta agenti autonomi, il caso mostra che comportamenti non intenzionali durante test interni possono avere conseguenze reali su infrastrutture esterne, e che i tempi di notifica contano quanto l'incidente stesso: OpenAI ha ammesso che 'i nostri modelli hanno compiuto azioni che non intendevamo'.
Tutto il resto
Modelli e ricerca
Fastino rilascia GLiNER2.5-Decide per decisioni strutturate su CPU
Fastino Labs ha rilasciato GLiNER2.5-Decide, encoder open-weight da 340M parametri per decision-making vincolato su schemi tipizzati, sotto licenza Apache 2.0. Gira su CPU con p50 di 167.3ms su un Xeon Platinum a 48 vCPU, e sul benchmark interno a 17 dataset ottiene lo score medio più alto (60.1%), superando baseline basate su Qwen3.5-4B. fastino.ai ➚
Claude scopre un nuovo sistema enzimatico CRISPR-like
Anthropic ha lanciato un gruppo di ricerca in biologia e riporta che Claude ha scoperto autonomamente un nuovo sistema enzimatico, chiamato array-associated reverse transcriptase (ART), con un pattern di ripetizioni DNA simile a CRISPR. Circa 950 agenti hanno lavorato 21 ore usando 210 milioni di token per individuare il pattern, poi validato in laboratorio; Feng Zhang, tra i pionieri di CRISPR, ha definito la scoperta 'genuinely intriguing'. anthropic.com ➚
xAI rilascia Grok 4.7 puntando su coding e sicurezza
xAI ha lanciato Grok 4.7, addestrato con un run di reinforcement learning più lungo su task complessi, mantenendo lo stesso prezzo di Grok 4.6 ($2/M input, $6/M output). Il modello introduce un nuovo stack di safeguard, con il 62.4% sul biosafety benchmark di LatchBio e appena il 3.3% di prompt rischiosi lasciati passare su HackerBench v0.3. x.ai ➚
Sei cloni di Jev spuntano in 48 ore
Dopo il lancio virale di Jev (36 milioni di visualizzazioni in due giorni, senza pesi open), la community ha prodotto sei repliche tra cui Laya (ModernBERT-large + PPO), Bespoke Nimble (LoRA su Qwen3.5-9B) e Kev-0.5B, eseguibile su un MacBook Pro. Il dibattito verte su Jev come nuovo primitivo discriminativo per routing e decisioni, alternativo alle LLM generative per compiti a basso costo marginale. latent.space ➚
Strumenti e applicazioni
Alibaba apre in open source un modello per diagnosi cliniche
Alibaba tramite Damo Academy ha rilasciato in open source Damo Radar, un vision-language model capace di identificare quasi 150 condizioni addominali, incluso il cancro, leggendo scansioni CT. Testato su quasi 40.000 esami reali, ha raggiunto un AUC medio di 0.913 su 146 reperti clinici, superando la maggior parte dei radiologi secondo uno studio pubblicato su Science. scmp.com ➚
Commenti dalla community